Kalibrierung und Validierung
Ein numerisches Modell enthält Parameter, die nicht direkt gemessen werden können, vor allem die Rauheit der Flusssohle. Kalibrierung passt diese Parameter an, bis das Modell Feldmessungen wiedergibt. Validierung testet dann das kalibrierte Modell mit Messungen, die nicht für die Kalibrierung verwendet wurden. aXqua führt beides mit HydroBayesCal durch.
In diesem Abschnitt werden zwei Begriffe verwendet. Kalibrierparameter sind die unsicheren Eingaben des Modells, die angepasst werden, zum Beispiel die Rauheit einer Zone. Kalibrierungsziele sind die gemessenen Größen, mit denen das Modell verglichen wird, beispielsweise die Wassertiefe an vermessenen Punkten.
Einführung in die Bayessche Kalibrierung
Eine Kalibrierung durch Versuch und Irrtum endet mit einem Satz von Parameterwerten und keiner Aussage darüber, wie zuverlässig diese Werte sind. Bayessche Kalibrierung beantwortet eine nützlichere Frage: Welche Parameterwerte sind angesichts der Messungen und ihrer Fehler wahrscheinlich?
Der Benutzer gibt für jeden Kalibrierparameter den Bereich an, in dem sein wahrer Wert erwartet wird. Dieser Bereich ist die A-priori-Verteilung. Bayes‘ Theorem kombiniert die A-priori-Verteilung mit den Messungen. Parameterwerte, mit denen das Modell die Messungen reproduziert, werden wahrscheinlicher und alle anderen werden weniger wahrscheinlich. Das Ergebnis ist die A-posteriori-Verteilung jedes Parameters. Eine enge A-posteriori-Verteilung zeigt an, dass die Messungen den Parameter gut bestimmen. Eine A-posteriori-Verteilung, die so breit ist wie die A-priori-Verteilung, zeigt an, dass die Messungen keine Informationen über diesen Parameter enthalten.
Die direkte Auswertung des Bayes-Theorems erfordert viele tausend Modellläufe, was für ein stundenlanges Modell nicht machbar ist. HydroBayesCal ersetzt das Modell daher in folgenden Schritten durch ein Ersatzmodell:
Das numerische Modell wird für eine begrenzte Anzahl von Parameterkombinationen ausgeführt, die über die A-priori-Verteilungsbereiche verteilt sind (standardmäßig 30).
Ein Gauß-Prozessemulator wird mit diesen Läufen trainiert. Der Emulator ist ein statistisches Modell, das das Ergebnis des numerischen Modells für jede Parameterkombination innerhalb eines Bruchteils einer Sekunde zusammen mit der Unsicherheit seiner eigenen Vorhersage vorhersagt (Rasmussen und Williams 2006).
Der Emulator wird für tausende Parameterkombinationen ausgewertet, um die A-posteriori-Verteilung zu berechnen.
Bayesisches aktives Lernen wählt die Parameterkombination aus, bei der ein zusätzlicher Durchlauf des numerischen Modells den Emulator am meisten verbessert. Das Modell wird für diese Kombination ausgeführt und der Emulator wird erneut trainiert (Oladyshkin et al. 2020).
Die Schritte 3 und 4 werden wiederholt, bis die ausgewählte Anzahl von Durchläufen erreicht ist (standardmäßig 50).
Auf diese Weise sind einige Dutzend Modellläufe ausreichend, wo eine direkte Bayessche Kalibrierung Tausende erfordern würde. Anwendungen auf Reservoirmodelle werden von Mouris et al. (2023) und Schwindt et al. (2023) dokumentiert.
Einrichtung von Referenzdaten
Feldmessungen werden als Referenzdaten bezeichnet. aXqua akzeptiert sie in einer Arbeitsmappe mit einer festen Struktur, die als Kalibrierzielvorlage bezeichnet wird. Erstellen Sie es für einen Fall mit:
axqua targets <case-file>
Der Befehl schreibt die Arbeitsmappe calibration-target-data.xlsx in user-sources/ground-truth/. Seine Blätter sind:
Blatt |
Inhalt |
|---|---|
|
Eine Reihe pro Messpunkt: Geschwindigkeitskomponenten, ihre Schwankungen, Wassertiefe und Sohlhöhe. Die Geschwindigkeitsgröße und die turbulente kinetische Energie werden durch Formeln im Blatt berechnet. |
|
Korngrößen (d16 bis d90) und der Feinsedimentanteil je Probe. Der gemessene Bettwechsel wird automatisch aus dem DGM der Differenz (Morphodynamische Simulation) ausgefüllt. |
|
Der Kalibrierparameter mit seinen unteren und oberen Grenzen, ausgewählt aus einer Liste der verfügbaren TELEMAC- und GAIA-Parameter. |
Jede Zeile trägt eine ID. Die Positionen der Messungen werden von einem Punktlayer ausgelesen, der die gleichen IDs enthält, so dass Koordinaten nicht eingegeben werden müssen. Geben Sie die Arbeitsmappe und den Punktlayer in die Fall-Datei ein:
ground_truth:
  targets:
    file: user-sources/ground-truth/calibration-target-data.xlsx
    hydraulics_positions: user-sources/geodata/measurement-points.gpkg
    sediment_positions: user-sources/geodata/sediment-samples.gpkg
    join_key: ID
Wiederholen Sie dann die Preprocessing, die die Messungen in den Tabellen kompiliert, die die Kalibrierung liest. Die IDs müssen in einem Blatt eindeutig sein. Messungen von mehreren Erhebungstagen, deren Nummerierung bei Null neu gestartet wird, erfordern daher eindeutige IDs.
Es gibt zwei Alternativen zur Arbeitsmappe. ground_truth.measurements benennt eine Tabelle, die der Benutzer zusammengestellt hat, mit den Koordinaten x, y und z in den ersten drei Spalten und einer Spalte pro gemessener Größe. ground_truth.sources listet die Originalinstrumentendateien zusammen mit dem Punktlayer ihrer Positionen auf, die aXqua in einer solchen Tabelle zusammenstellt.
Messungen in einem Layer oder Tabelle. Wenn die Messwerte und deren Positionen bereits in einer Datei vorhanden sind, reicht diese aus. Betreten Sie es als Quelle der Art points:
ground_truth:
  sources:
    - category: hydraulics
      kind: points
      positions: user-sources/ground-truth/velocity-measurements.gpkg
Die Datei ist ein Punktlayer (GeoPackage, Shapefile oder GeoJSON) in einem beliebigen Koordinatenbezugssystem oder eine Tabelle (CSV-Datei oder Excel-Arbeitsmappe) mit den Spalten x und y im Koordinatenbezugssystem des Falls. aXqua erkennt die folgenden Spaltennamen in Groß- oder Kleinschreibung und mit oder ohne Einheit in eckigen Klammern oder Klammern, zum Beispiel v(x) [m/s] oder v_x (m/s):
Menge |
Spaltenbezeichnungen |
|---|---|
Koordinaten einer Tabelle |
|
Geschwindigkeitsanteile in m/s |
|
Wassertiefe insgesamt in m |
|
Tiefe einer Anzeige unterhalb des Wasserspiegels in m |
|
Die Geschwindigkeitsgröße, die mit dem Modell verglichen wird, wird aus den horizontalen Komponenten berechnet. Wenn ein Layer mehrere Messwerte an einer Position enthält, verwendet aXqua den Messwert, der 0,6 der Wassertiefe unter der Oberfläche am nächsten liegt, was der Tiefe-gemittelten Geschwindigkeit nahe kommt. Punkte außerhalb der Modellgrenze werden bei der Kalibrierung ausgelassen. Im Plugin werden die Dateien in den Fall-Einstellungen (Open case settings… auf der Registerkarte Case Setup), Seite Calibration and validation, in der Tabelle Measurement files des Frames Measurements. Add file… fügt einen Punktlayer oder eine Tabelle hinzu, und die Spalte Use for weist jede Datei der Kalibrierung oder der Validierung zu. Eine Datei für die Validierung benötigt den Namen ihrer Abflusssituation und ihrer Abfluss (Validierungssituation).
Geschwindigkeitsmessungen mit einem SonTek FlowTracker2 werden in das hydraulics Blatt mit dem Skript extract_flowtracker.py übertragen, das aXqua neben der Arbeitsmappe platziert. Beachten Sie, dass die Geschwindigkeitsschwankungen die Standardabweichung der Geschwindigkeitsproben sind. Es ist nicht die Spalte VxErr des Instrumentenexports, was der Standardfehler der mittleren Geschwindigkeit ist.
Bayessche Kalibrierung und Validierung
Der calibration-Block der Fall-Datei definiert, was mit welchen Messungen kalibriert wird:
calibration:
  calibration_quantities: ["WATER DEPTH"]
  extraction_quantities: ["WATER DEPTH", "SCALAR VELOCITY"]
  measurement_error: 0.10     # used where no measured error is available
  init_runs: 30               # runs for the first training of the emulator
  max_runs: 50                # total number of runs
  parameters:
    - {name: zone1, min: 0.05, max: 0.50}   # ks of roughness zone 1 [m]
    - {name: zone2, min: 0.10, max: 1.00}   # ks of roughness zone 2 [m]
calibration_quantities sind die Kalibrierziele. Die Namen sind die der TELEMAC-Ergebnisvariablen: WATER DEPTH, SCALAR VELOCITY, TURBULENT ENERG. (erfordert das k-epsilon Turbulenzmodell) und CUMUL BED EVOL (erfordert GAIA).
parameters listet den Kalibrierparameter mit den Grenzen ihrer A-priori-Verteilungsbereiche auf. Der Name zone<N> bezieht sich auf die Rauheit der Zone N. Ein Name, der mit gaia beginnt, bezieht sich auf ein GAIA-Schlüsselwort, beispielsweise gaiaCLASSES SHIELDS PARAMETERS 1 für den kritischen Shields-Parameter der ersten Korngröße-Klasse. Parameter, die im parameters-Blatt der Arbeitsmappe ausgewählt werden, werden dieser Liste hinzugefügt.
Wählen Sie breite, aber physisch plausible Grenzen. Wenn sich die A-posteriori-Verteilung eines Parameters an einer seiner Grenzen ansammelt, liegt der wahre Wert wahrscheinlich außerhalb des Bereichs und die Kalibrierung muss mit einem größeren Bereich wiederholt werden.
Validierung. Eine Validierung prüft, ob die kalibrierten Parameter den Flussabschnitt oder nur den Tag beschreiben, an dem die Kalibrierdaten gemessen wurden. Sie erfordert daher Messungen, die die Kalibrierung nicht verwendet hat und die aus einer anderen Abflusssituation stammen: eine weitere Abfluss, gemessen in einer anderen Umfrage.
Alle Messungen des ground_truth Blocks sind Kalibrierungsdaten. aXqua hält keinen Teil davon für eine Validierung zurück. Die Messungen einer Vermessung werden innerhalb weniger Stunden in einem Strömungsfeld durchgeführt und benachbarte Punkte sind daher nicht unabhängig voneinander. Ein Modell, das einige dieser Punkte von den anderen vorhersagt (einzige Kreuzvalidierung, k-fache Kreuzvalidierung oder einen zufälligen Anteil), zeigt, dass es innerhalb dieses Flussfeldes interpoliert. Es zeigt nicht, dass seine Rauheit-Werte an einem anderen Abfluss gelten, an dem andere Teile des Bettes benetzt und andere Rauheit-Elemente untergetaucht sind.
Die Validierungsdaten werden in der Fall-Datei als situation mit ihren Messungen und ihren Rand-Werten definiert:
calibration:
  validation:
    - name: September 2025
      inflows: {1: 0.2, 3: 5.1}    # discharge [m3/s] per inflow of the model
      sources:
        - category: hydraulics
          kind: points
          positions: user-sources/ground-truth/september.gpkg
Eingang |
Bedeutung |
|---|---|
|
Ein kurzer Name der Situation. Es benennt die Dateien der Validierung. |
|
Die Messungen, in Form der Quellen des |
|
Der gesamte Abfluss der Situation in m3/s. Bei einem Modell mit mehreren Zuflüssen wird der Abfluss unter ihnen in den Proportionen des kalibrierten Falls verteilt. |
|
Der Abfluss jedes Zuflusses in m3/s, für einen Flussabschnitt, dessen Zweige einen anderen Anteil des Flusses trugen. Die Zuflüsse werden durch die Nummer ihres täters Rand identifiziert. |
|
Der Wasserstand am Ausfluss in m, für einen Fall mit |
|
Die simulierte Zeit in Sekunden, wenn sie sich von der des Falls unterscheidet. |
Im Plugin. Die Registerkarte Calibration & validation hat die Box Validation with data of another flow situation. Wählen Sie den Punktlayer mit den Validierungsdaten mit Browse… oder mit From QGIS… aus dem Punktlayer, die in QGIS geöffnet sind. Geben Sie den Abfluss jedes Zuflusses ein: Das Feld listet die Zuflüsse des Modells mit dem Abfluss des kalibrierten Falls auf. Save schreibt die Situation in die Fall-Datei. Die gleichen Situationen erscheinen in den Herbst-Einstellungen (Open case settings…, Seite Calibration and validation): In der Tabelle Measurement files, jede Datei, deren Spalte Use for sagt Validation gehört zu der Situation in der Spalte Situation, mit dem Abfluss dieser Situation. Der Abfluss gehört zur Situation, so dass eine Änderung in einer Zeile sie in jeder Zeile dieser Situation ändert, und ein Pfad in den Spalten File und Positions kann an Ort und Stelle korrigiert werden. Einstellungen einer Situation, die die Tabelle nicht zeigt, wie der Abfluss jedes Zuflusses, werden beibehalten.
Lauf HydroBayesCal
Die Kalibrierung erfordert das zusätzliche Paket HydroBayesCal (QGIS Plugin) und einen gebauten Fall mit einer abgeschlossenen stationären Simulation. Jeder Lauf der Kalibrierung wiederholt diese stationäre Simulation mit einem anderen Satz von Parameterwerten.
Klicken Sie im Plugin auf Submit auf der Registerkarte Calibration & validation. Die Option Prepare only schreibt alle Eingabedateien, ohne die Runs zu starten, so dass sie zuerst inspiziert werden können. In einem Terminal:
axqua submit <case-file> --kind calibration --option prepare_only=true
axqua submit <case-file> --kind calibration
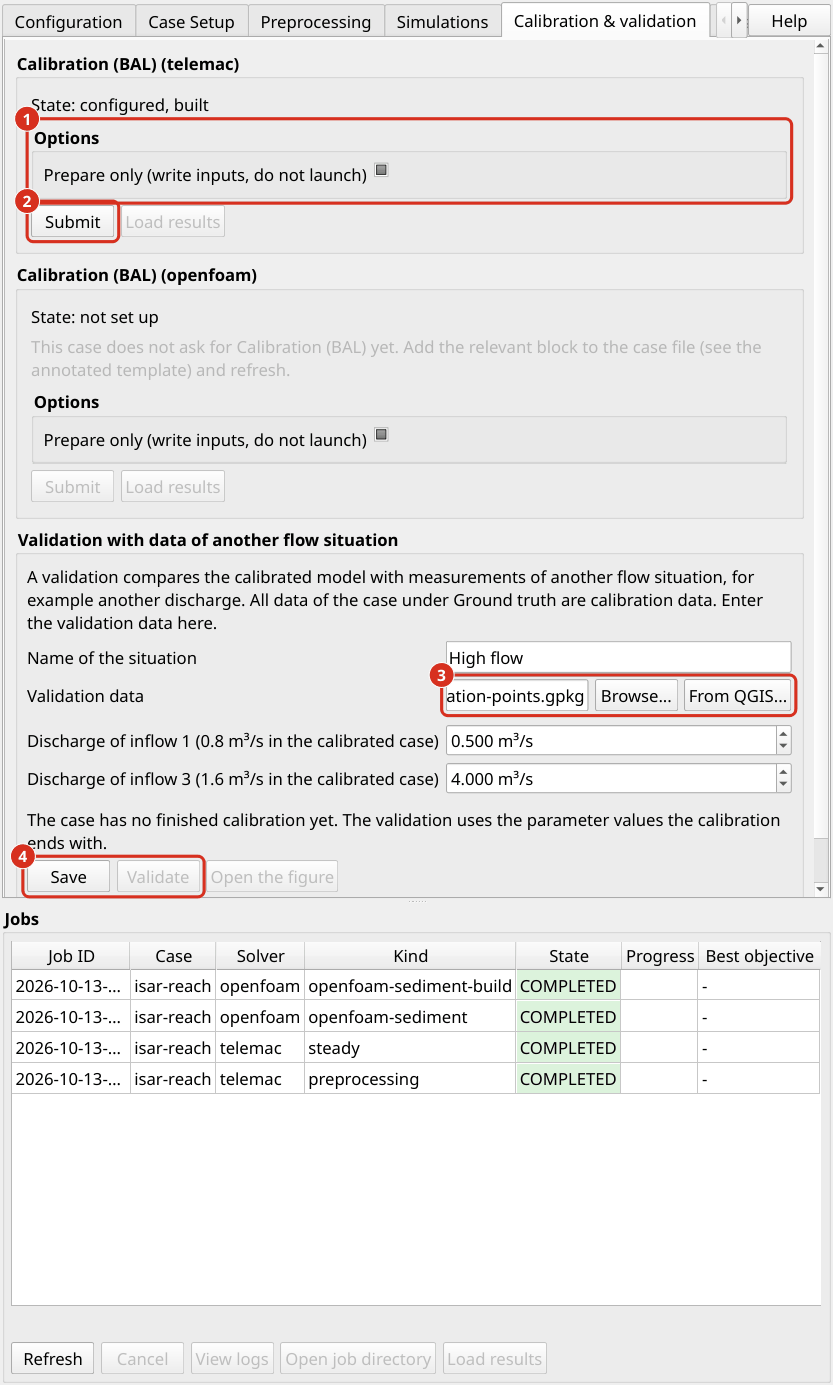
Die Registerkarte Calibration & validation für ein Fall mit Messungen. (1) Die Option Prepare only. (2) Submit startet die Kalibrierung. (3) Die Messungen der Validierungssituation, ausgewählt als Datei oder von Layer, die in QGIS geöffnet sind, und darunter der Abfluss von jedem Zufluss in dieser Situation. (4) Save speichert die Validierungssituation in der Fall-Datei und Validate führt sie aus.
Die Rechenzeit ist ungefähr die Anzahl der Durchläufe (max_runs) mal die Dauer einer stationären Simulation. Die Jobliste zeigt die Nummer des aktuellen Laufs, zum Beispiel iter 5/12.
HydroBayesCal führt seine Läufe im Ordner des gebauten Falls aus (axqua-case/simulation/) und schreibt jeden getesteten Satz von Parameterwerten in den Friktionstisch und den dortigen Steuerdatei. aXqua stellt beide Dateien nach Beendigung der Kalibrierung wieder her, so dass eine spätere Simulation den Fall so verwendet, wie er gebaut wurde. Aus dem gleichen Grund laufen Jobs von einem Fall nach dem anderen: Ein Job, der während einer Kalibrierung eingereicht wird, wartet, bis die Kalibrierung beendet ist. Der Ordner cases/example-isar/ des Repositorys enthält ein vollständiges Beispiel mit einer Laufzeit von etwa einer halben Stunde, einschließlich einer Schritt-für-Schritt-Anleitung für das Plugin.
Validierungslauf. Klicken Sie nach der Kalibrierung auf Validate in der Box Validation with data of another flow situation oder senden Sie den Job in einem Terminal:
axqua submit <case-file> --kind validation
Die Validierung führt das kalibrierte Modell mit den Randwerten der Validierungssituation aus. Sein Steuerdatei leitet sich von dem des gebauten Falls ab und unterscheidet sich nur in den vorgeschriebenen Abflüssen und Wasserständen, in den Namen der eigenen Ergebnisdateien und in den kalibrierten Parameterwerten. Das Rechennetz und alle anderen Einstellungen sind die des kalibrierten Modells, so dass ein Unterschied zwischen Modell und Messung nicht von einem Modell herrühren kann, das anders gebaut wurde. Die kalibrierten Werte sind die wahrscheinlichste Kombination der A-posteriori-Verteilung (das gemeinsame A-posteriori-Verteilung Maximum) der letzten Kalibrierung. Die Dateien des gebauten Falls und das Ergebnis der stationären Simulation werden nicht verändert.
aXqua liest dann das Modell an den Validierungspunkten und schreibt drei Dateien in axqua-case/calibration-validation/validation/: eine Tabelle mit dem gemessenen und dem modellierten Wert an jedem Punkt (validation-<name>.csv), eine Zusammenfassung (validation-<name>.json) und eine Zahl des modellierten gegen die gemessenen Werte (validation-<name>.png). Messpunkte außerhalb des Modells werden gezählt und ausgeschlossen.
Mehrere Abflüsse. Rauheit-Werte, die an einem Abfluss kalibriert wurden, sind nicht unbedingt an einem anderen gültig. Das Skript run_Bayes_cal_multiflow.py im Fall-Ordner kalibriert einen gemeinsamen Satz von Parametern gegen Messungen an mehreren Abflüssen. Führen Sie es mit --smoke zuerst. Dieser kurze Test mit drei Durchläufen überprüft die gesamte Kette, bevor Tage der Rechenzeit verbracht werden.
OpenFOAM. Ein OpenFOAM-Modell kann mit dem Skript run_Bayes_cal_openfoam.py gegen gemessene Geschwindigkeitskomponenten kalibriert werden. Da eine Kalibrierung Dutzende von Durchläufen erfordert, werden sie mit einem groben Rechennetz im Modus rigid-lid durchgeführt. Das Skript openfoam_verify_posterior.py wiederholt dann den kalibrierten Fall mit voller Auflösung im Modus vof. Die Rauheit eines OpenFOAM-Modells wird als ein Wert für das gesamte Bett kalibriert. Sie ist daher nicht vergleichbar mit den Rauheit-Werten pro Zone einer TELEMAC-Kalibrierung.
Qualitätsanalyse
HydroBayesCal schreibt seine Ergebnisse in den Ordner auto-saved-results-HydroBayesCal innerhalb axqua-case/calibration-validation/. Beurteilen Sie eine Kalibrierung in vier Schritten:
Hat sich das aktive Lernen angenähert? HydroBayesCal zeichnet nach jeder Iteration zwei Indikatoren auf. Der Bayessche Modellnachweis (BME) drückt aus, wie gut das Modell die Messungen im Durchschnitt über die Parameterbereiche reproduziert. Die relative Entropie (RE) gibt an, wie viele Informationen die Messungen der A-priori-Verteilung hinzugefügt haben. Beide sollten sich gegen Ende der Kalibrierung abgleichen. Wenn sie sich immer noch stark ändern, erhöhen Sie
max_runs.Ist die A-posteriori-Verteilung schmaler als die A-priori-Verteilung? Vergleichen Sie die beiden Verteilungen jedes Parameters. Eine A-posteriori-Verteilung, die deutlich schmaler als die A-priori-Verteilung ist und innerhalb des Bereichs liegt, identifiziert den Parameter. Eine A-posteriori-Verteilung an einer Grenze des Bereichs erfordert eine größere Reichweite. Eine A-posteriori-Verteilung, die der A-priori-Verteilung ähnelt, bedeutet, dass die Messungen diesen Parameter nicht einschränken.
Reproduziert das kalibrierte Modell die Kalibrierziele? Der kalibrierte Parametersatz ist die wahrscheinlichste Kombination der A-posteriori-Verteilung. HydroBayesCal vergleicht die Modellergebnisse für dieses Set mit den Messungen. Prüfen Sie, ob die verbleibenden Differenzen der Größe der Messfehler entsprechen und ob sie zufällig verteilt oder in einem Teil des Flussabschnitts konzentriert sind. Eine systematische Abweichung weist auf einen Fehler im Modell hin, beispielsweise in den Geländedaten oder den Randbedingungen, den kein Parameterwert kompensieren kann.
Reproduziert das kalibrierte Modell unabhängige Daten? Führen Sie die Validierung aus (Validierungslauf). Die Unterschiede sind typischerweise etwas größer als bei den Kalibrierzielen. Viel größere Unterschiede deuten darauf hin, dass die Kalibrierung Fehler der Modellstruktur durch die Parameter kompensiert hat.
Die Validierung meldet für jede Größe die folgenden Statistiken, z. B. die Fließgeschwindigkeit und die Wassertiefe:
Statistik |
Bedeutung |
|---|---|
Anzahl Punkte |
Die Validierungspunkte auf dem Rechennetz des Modells. Punkte außerhalb des Modells und Punkte, die im Modell trocken sind, obwohl Wasser gemessen wurde, werden separat gemeldet. |
Bias |
Der Mittelwert der modellierten Werte abzüglich der Messwerte. Eine negative Verzerrung der Geschwindigkeit bedeutet, dass das Modell im Durchschnitt zu langsam ist. Die relative Vorspannung bezieht sich auf den mittleren Messwert. |
Root Mean Square Error (RMSE) |
Der typische Unterschied zwischen Modell und Messung an einem Punkt. Es enthält die Verzerrung und die Streuung. |
Mittlerer absoluter Fehler |
Die mittlere Größe der Differenzen, die für einzelne große Differenzen weniger empfindlich ist als die RMSE. |
Korrelation |
Der Korrelationskoeffizient zwischen modellierten und gemessenen Werten. Eine hohe Korrelation mit einer großen Verzerrung zeigt ein korrektes räumliches Muster auf einer falschen Ebene an. |
Anteil am Messfehler |
Der Anteil der Punkte, an denen sich Modell und Messung um nicht mehr als den Fehler der Messung unterscheiden. Der Fehler ist der des Instruments kombiniert mit dem relativen |
Die Validierung gibt auch die verbleibende Differenz zwischen Zufluss und Ausfluss am Ende des Laufs an. Wenn dieser Unterschied die Toleranz des Falls übersteigt, hatte der Lauf keinen stationären Zustand erreicht und der duration der Validierungssituation muss erhöht werden.
Das HydroBayesCal Dokumentation beschreibt die Ergebnisdateien und Zahlen im Detail.
Referenzen
Mouris, K., Acuña Espinoza, E., Schwindt, S., Mohammadi, F., Haun, S., Wieprecht, S., and Oladyshkin, S. (2023). „Stability criteria for Bayesian calibration of reservoir sedimentation models.“ Modeling Earth Systems and Environment, 9, 3643-3661. doi:10.1007/s40808-023-01712-7
Oladyshkin, S., Mohammadi, F., Kroeker, I., and Nowak, W. (2020). „Bayesian3 active learning for the Gaussian process emulator using information theory.“ Entropy, 22(8), 890. doi:10.3390/e22080890
Rasmussen, C. E., and Williams, C. K. I. (2006). Gaussian processes for machine learning. MIT Press.
Schwindt, S., Callau Medrano, S., Mouris, K., Beckers, F., Haun, S., Nowak, W., Wieprecht, S., and Oladyshkin, S. (2023). „Bayesian calibration points to misconceptions in three-dimensional hydrodynamic reservoir modeling.“ Water Resources Research, 59(3), e2022WR033660. doi:10.1029/2022WR033660